
 下载APP


在全球药物研发版图中,GPCR(G 蛋白偶联受体)是当之无愧的 “药靶之王”——人类基因组中超过800个GPCR成员,介导着从神经传导、免疫调节到代谢稳态的几乎所有生理过程。据2025年《Nature Reviews Drug Discovery》统计,全球获批药物中约36%靶向 GPCR家族。
但抗体药物在这一领域的进展始终缓慢:全球上市的GPCR治疗性抗体药物屈指可数,绝大多数靶点仍处于无药可及的状态。
直到AI从头设计的出现,开始撬动这一僵局。
近期,分子之心发布MMDesign平台最新技术报告,在6个GPCR靶点的VHH纳米抗体从头设计中,全部获得实验确认的结合分子,且每个靶点只做了9至33个候选的实验。
其中,NK3R靶点实现30/30全命中,GPR68命中率达90.9%,且6个靶点的最佳表观亲和力均达到纳摩尔级。更具突破分量的是,这6个靶点中有5个在权威治疗性抗体数据库中无上市抗体记录,属于公认的难成药靶点。
这为AI从头设计攻克高难度膜蛋白靶点补上了关键的实证拼图。更重要的是,分子之心与MMDesign给出的答案,远不止GPCR这块“硬骨头”。
/ 01 /最大的靶点家族,最深的抗体成药“深水区”
要理解分子之心这份答卷的分量,先要清楚GPCR为何是“深水区”。
作为人体最大的膜蛋白家族,GPCR抗体开发困难,难在三个绕不开的现实。
第一,胞外表位狭窄且高度动态。GPCR大部分结构镶嵌在疏水细胞膜中,可供抗体结合的胞外表位相对有限。同时受体构象会在激活态、非激活态间持续切换,难以形成稳定的抗体结合界面,可供识别的热点区域有限;
第二,计算结构建模干扰大。传统结构预测模型在可溶性蛋白上的高精度表现,迁移到GPCR这类膜蛋白场景时往往精度下降,难以精准模拟抗体与胞外表位的结合模式。这也是AI从头设计切入GPCR时,必须跨过的核心技术门槛;
第三,成药经验稀缺。截至2026年初,全球获批的靶向GPCR的抗体药物仍只有三款:erenumab、mogamulizumab和talquetamab(双抗),绝大多数靶点没有成熟的抗体开发先例可循,甚至连有效的筛选体系都难以建立。
这些造成了一种明显的失衡:据统计,适合抗体介入的GPCR超过180个,对应近 430个靶向治疗机会,至今却只有极少的有效分子产出。也正因此,能否高效产出GPCR结合抗体,成为检验AI从头设计平台真实能力的核心“试金石”。
/ 02 /6靶点全命中:MMDesign的GPCR成绩单
分子之心这次的测试,选得足够“硬核”。
测试共覆盖18个靶点、19个项目,18个项目确认命中(94.7%),GPCR是其中高难度的验证子集,共验证6个GPCR靶点——NK3R、GPR68、CCR7、EP2、A2AR、CCR8,覆盖趋化因子受体、神经肽受体、脂质受体等多个亚类,横跨自免、肿瘤、中枢神经系统疾病。
其中,NK3R、GPR68、CCR7、EP2、A2AR这5个靶点在Thera-SAbDab全球治疗性抗体数据库中,无已上市且公开序列的抗体记录,属于行业内缺乏成熟开发经验的难成药靶点。
这些靶点的临床价值也颇为突出:A2AR是肿瘤免疫腺苷通路的经典检查点,CCR8靶向肿瘤相关Treg与巨噬细胞,CCR7关联淋巴细胞归巢与血液肿瘤,NK3R涉及中枢神经与女性健康领域,GPR68、EP2锚定炎症与肿瘤信号。
选择这类靶点作为测试集,验证的含金量远高于结构清晰、成药经验丰富的经典靶点。从结果来看,MMDesign针对每个靶点仅筛选数十个候选进入实验,最终6个靶点全部获得确认结合的VHH分子。
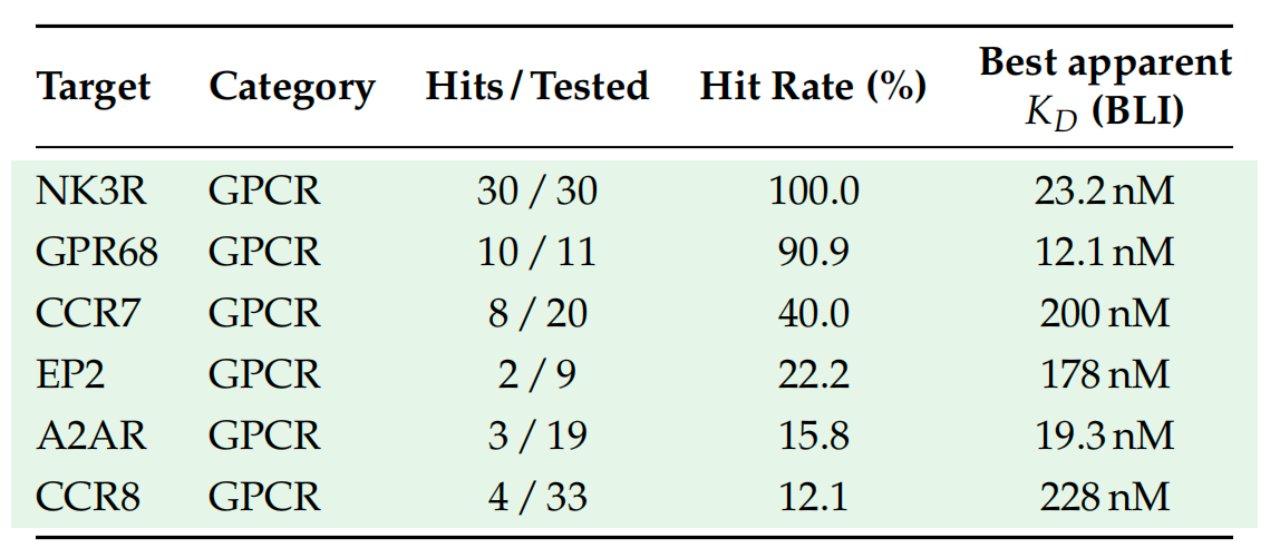
6个GPCR靶点的VHH从头设计实验验证结果
从命中率维度看,平台实现了低筛选量级下的高富集。每个靶点仅测试9至33个候选分子,就获得了明确阳性结果。其中,NK3R靶点在测试的30个候选中实现100%结合阳性,GPR68命中率达到90.9%。这在传统筛选模式中是不可想象的效率。
从亲和力质量看,6个靶点的最佳表观亲和力均进入纳摩尔级:GPR68 达 12.1 nM,A2AR 达 19.3 nM,NK3R 达 23.2 nM。这样的数据为后续亲和力成熟和体内研究提供了起点。
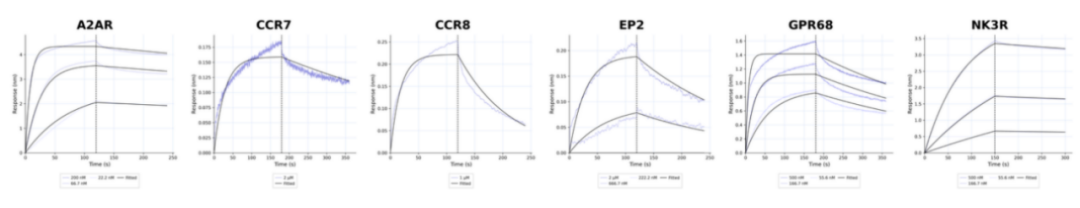
6个GPCR靶点阳性VHH分子的多浓度BLI结合动力学曲线(1:1全局拟合)
除了结合活性,这批分子的初步可开发性表现同样值得关注。报告显示,多数MMDesign设计的VHH-Fc候选分子能在CHO细胞中稳定表达,纯化后的分子能保持单体状态,聚集迹象较少,并在针对胰岛素和双链DNA的替代性检测中呈现较低非特异性反应。
各靶点VHH-Fc融合蛋白在CHO细胞中的表达产量分布/各靶点VHH-Fc候选分子的SEC-HPLC单体组分占比分布
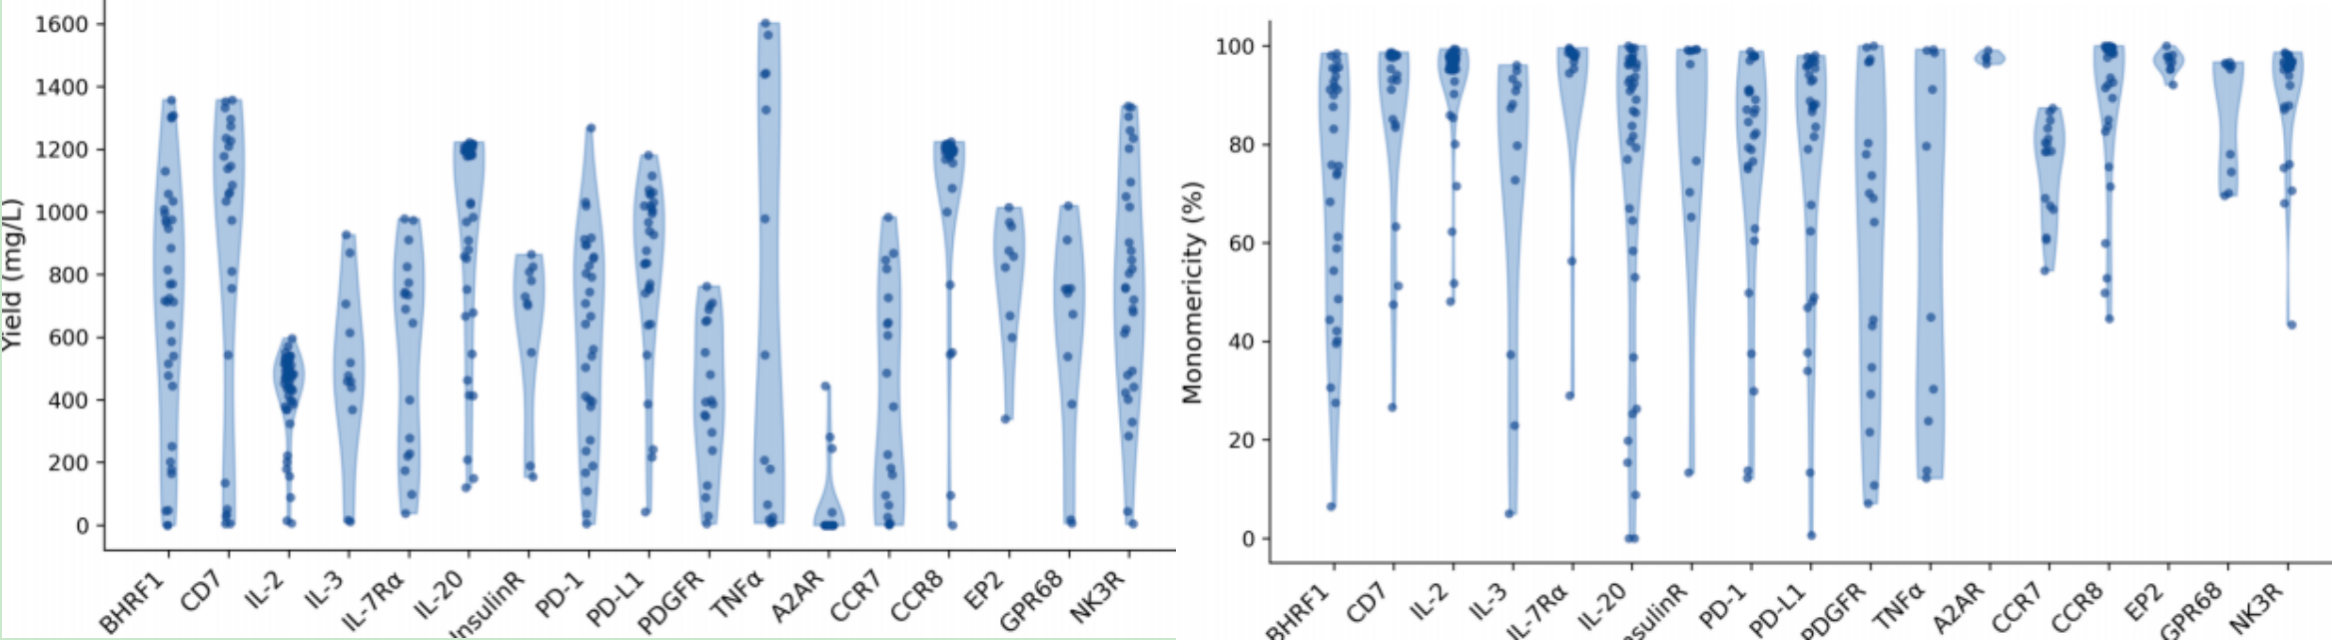
这是积极的初步可开发性信号,表明MMDesign设计的不仅是能够结合靶点的序列,还兼顾了初步的类药分子属性。
/ 03 /技术内核拆解,分子之心凭什么
抗体从头设计面临生成有效候选与高效优选的双重挑战,面对GPCR这类复杂靶点时,挑战尤为突出。MMDesign能在低实验量下实现高命中率,靠的是生成大模型、结构预测引擎与多层过滤体系的全链路协同。
生成,解决“从筛到造”。AI从头设计的第一步,是跳出“从已有文库里筛选”的逻辑,针对靶点表位定向创造结合分子。
作为全球AI蛋白质折叠与设计领域的开拓者,许锦波早在AlphaFold问世前就率先将深度学习系统性引入蛋白质结构预测,其研发的RaptorX系列算法曾多年保持领域精度纪录。创立分子之心后,于2023年推出多模态AI蛋白质生成大模型NewOrigin(达尔文),融合序列、结构、功能与进化信息,为蛋白质生成与优化提供强大技术基座。
在具体设计中,MMDesign通过“幻觉引导”的序列—结构协同优化构建候选,不以检索已知抗体序列作为设计起点。与公开序列和结构数据库的比较显示,部分设计分子的CDR区,尤其是CDR3,在序列或构象上与已知抗体存在明显差异。
结构预测,解决“产出的分子准不准”。MMDesign的结构建模核心是自研的全原子结构预测模型MMFold,针对抗体-抗原复合物建模做了专项训练。在国际权威的FoldBench172个抗体-抗原界面测评中,MMFold的Top-1整体预测成功率达70.9%,其中“高质量”预测成功率达39.0%,两项指标均大幅优于AlphaFold 3、Boltz-1、Chai-1等主流模型。高精度的结构预测为海量计算空间中的精准筛选提供了可靠保障。
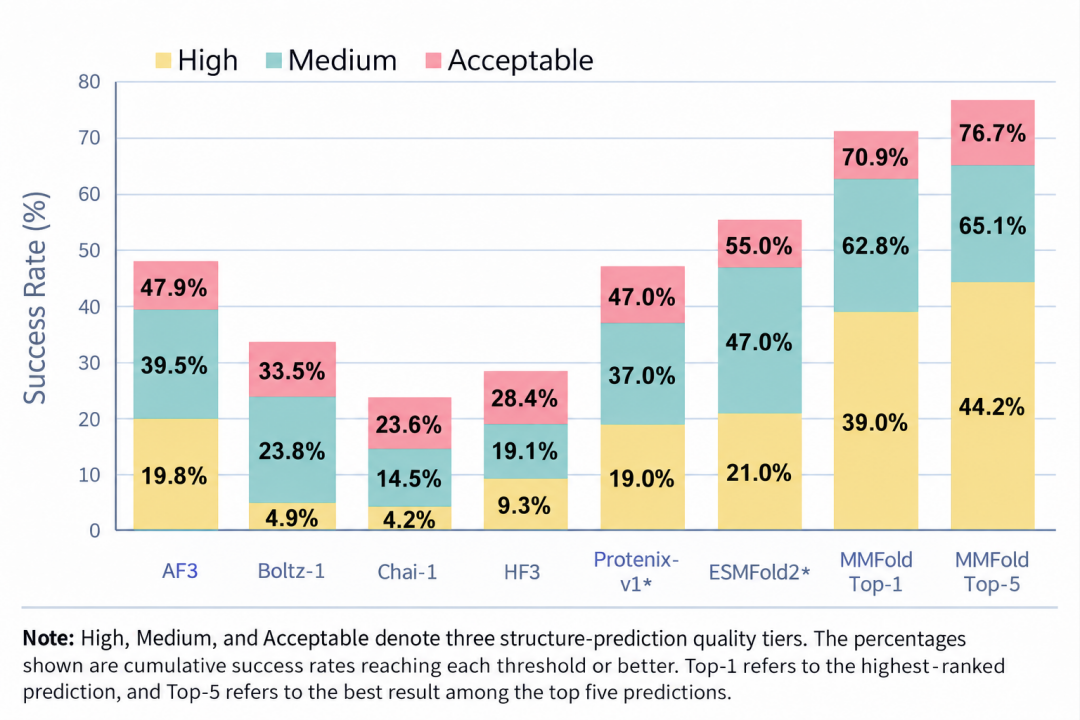
MMFold与主流结构预测方法的抗体–抗原复合物预测性能对比
三层过滤,解决“从数万到几十个分子”。在生成与结构预测的基础上,MMDesign采用“生成-过滤-验证”的统一工作流:先通过 “幻觉引导” 的序列-结构协同优化生成数万个候选,再经三层递进式过滤,最终优选仅几十个分子进入实验验证。简单来说:
结构可靠性层:从结构置信度、多种子重现性、跨模型一致性、表位接触验证四个维度,降低构象预测不一致、结合模式不可靠的候选的优先级;
可表达性层:通过蛋白语言模型评估序列天然性,结合表面性质过滤,去除预测聚集倾向高的分子;
结合特异性层:自研统计物理结合预测模块,估算结合自由能,筛选预测界面特征符合特异性分子识别的候选。
生成、结构预测与多层过滤协同支撑了MMDesign能在最低仅测个位数分子的量级下,实现高效率命中。
/ 04 /可复用的平台能力:从技术突破到研发新路径
6个GPCR靶点的突破,并非单点的“幸运命中”。从整体测试报告看,MMDesign这套“生成—过滤—验证”流程,正在展现跨靶点、跨模态、可迭代的平台化分子发现能力。
跨靶点层面,除了GPCR,本次报告还完成了另外10个靶点的验证,覆盖检查点、细胞因子、受体、病毒蛋白等类型。其中,PD-L1为26/30(命中率86.7%,最佳KD 7.2 nM)、TNFα为7/14(最佳表观KD 51 pM)。
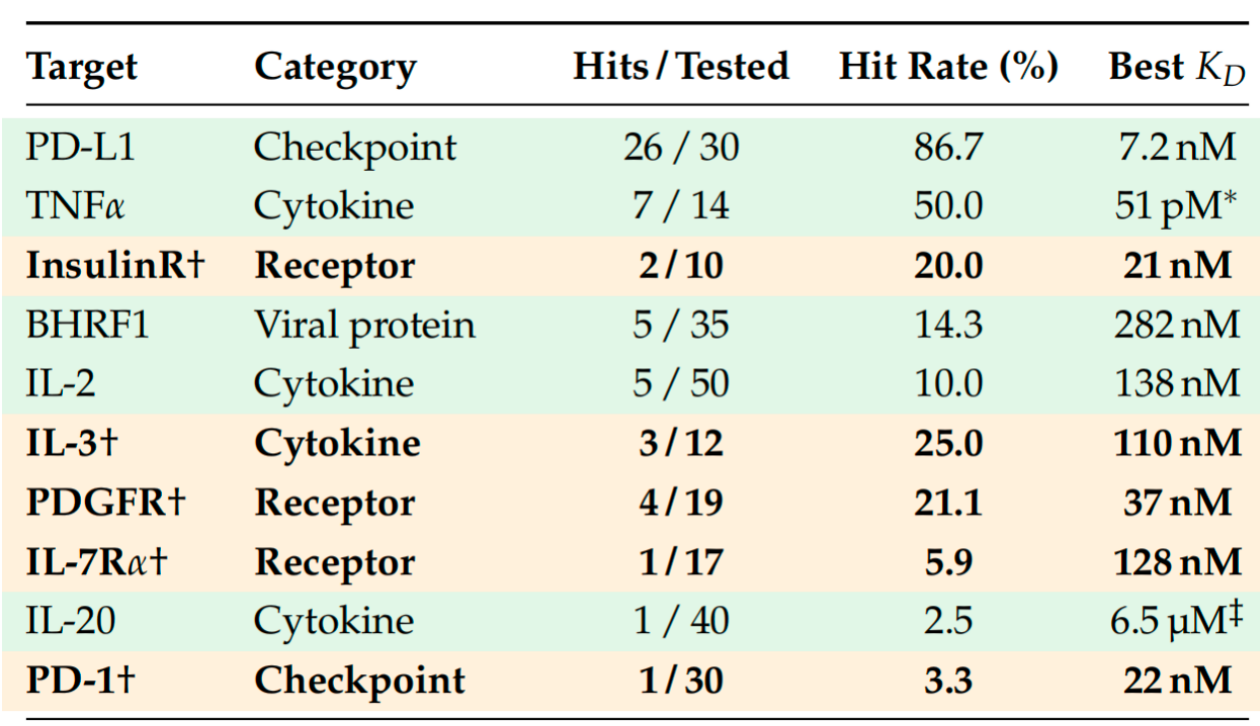
10个目标靶点的实验验证结果
这意味着,平台的能力不局限于GPCR,在经典可溶性靶点上同样能稳定输出结合分子,具备广谱的靶点适配性。
跨模态层面,MMDesign的能力边界并不局限于VHH抗体,平台还成功针对PD-L1、MDM2两个靶点生成了大环多肽结合分子。
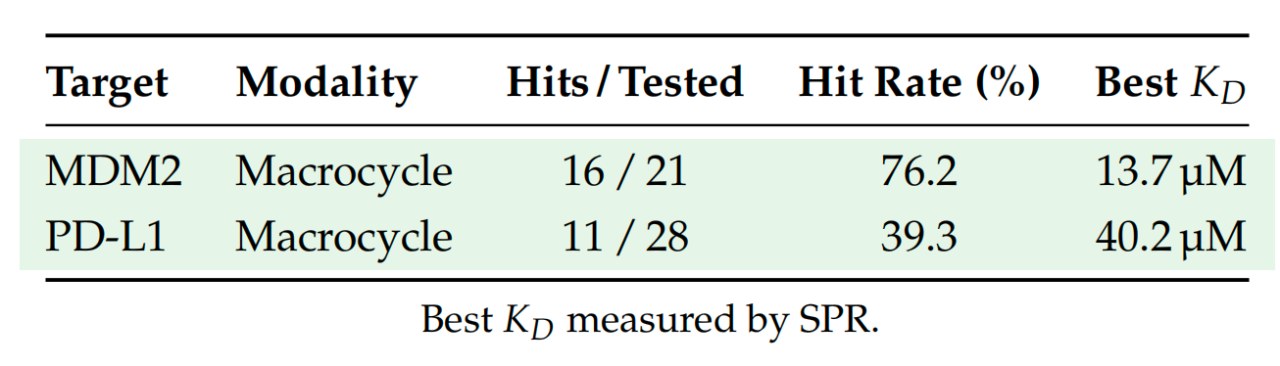
MDM2与 PD-L1大环多肽从头设计的实验验证结果
对于药物研发而言,多模态能力的价值尤为突出:VHH分子量小、结构紧凑,具有组织渗透潜力;大环多肽兼具小分子的化学可及性和生物药的特异性,在需要口服递送的场景中颇具潜力。
平台能力的另一重体现,是可重复、可优化的迭代能力。报告数据显示,针对6个此前已命中的靶点重新进行设计,最终5个靶点实现了命中率或亲和力的提升,部分完成双重优化。以PDGFR为例,候选命中率和最佳亲和力分别获得了5.2倍和4倍的提升。
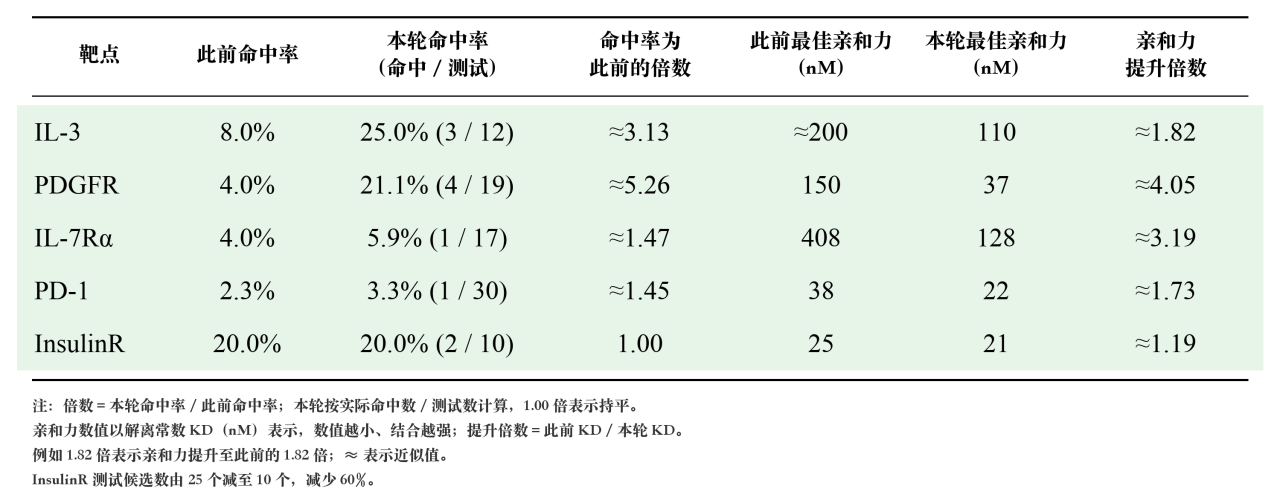
再设计的表现提升
对AI蛋白质设计而言,一次成功的分子设计固然令人振奋,但真正决定技术产业价值的,是能否在不同靶点、不同分子类型和多轮优化中持续产出具有实验活性的候选分子。而目前,MMDesign正在展示其将计算设计转化为可复用分子发现流程的潜力。
正如许锦波所言,“这次扩展评估的重要意义,在于将一次性的设计成功,逐步转化为可重复、可扩展的研发能力。AI生物药研发的长期价值,不只是单个模型的性能突破,更在于通过自主底层模型与生成、评估、实验验证的协同,让精准分子设计成为能够持续解决不同研发问题的技术基础设施。”
当然,从体外结合活性到真正具备治疗价值的候选药物,还需要经历功能验证、成药性优化以及临床前和临床研究等多重考验。
但至少在药物发现的起点,AI正在改变研究人员寻找分子的路径:从依赖大规模实验筛选,逐步走向计算生成、理性优选与实验验证相结合的新路径。这或许才是MMDesign此次成果最值得行业关注的长期价值。

 下载APP

